먼저 기억할 것
신규와 갱신을 구분할 수 있다면 각각의 표본을 먼저 보세요. 두 종류를 섞은 평균만으로 신규 계약 조건을 설명하기는 어렵습니다.
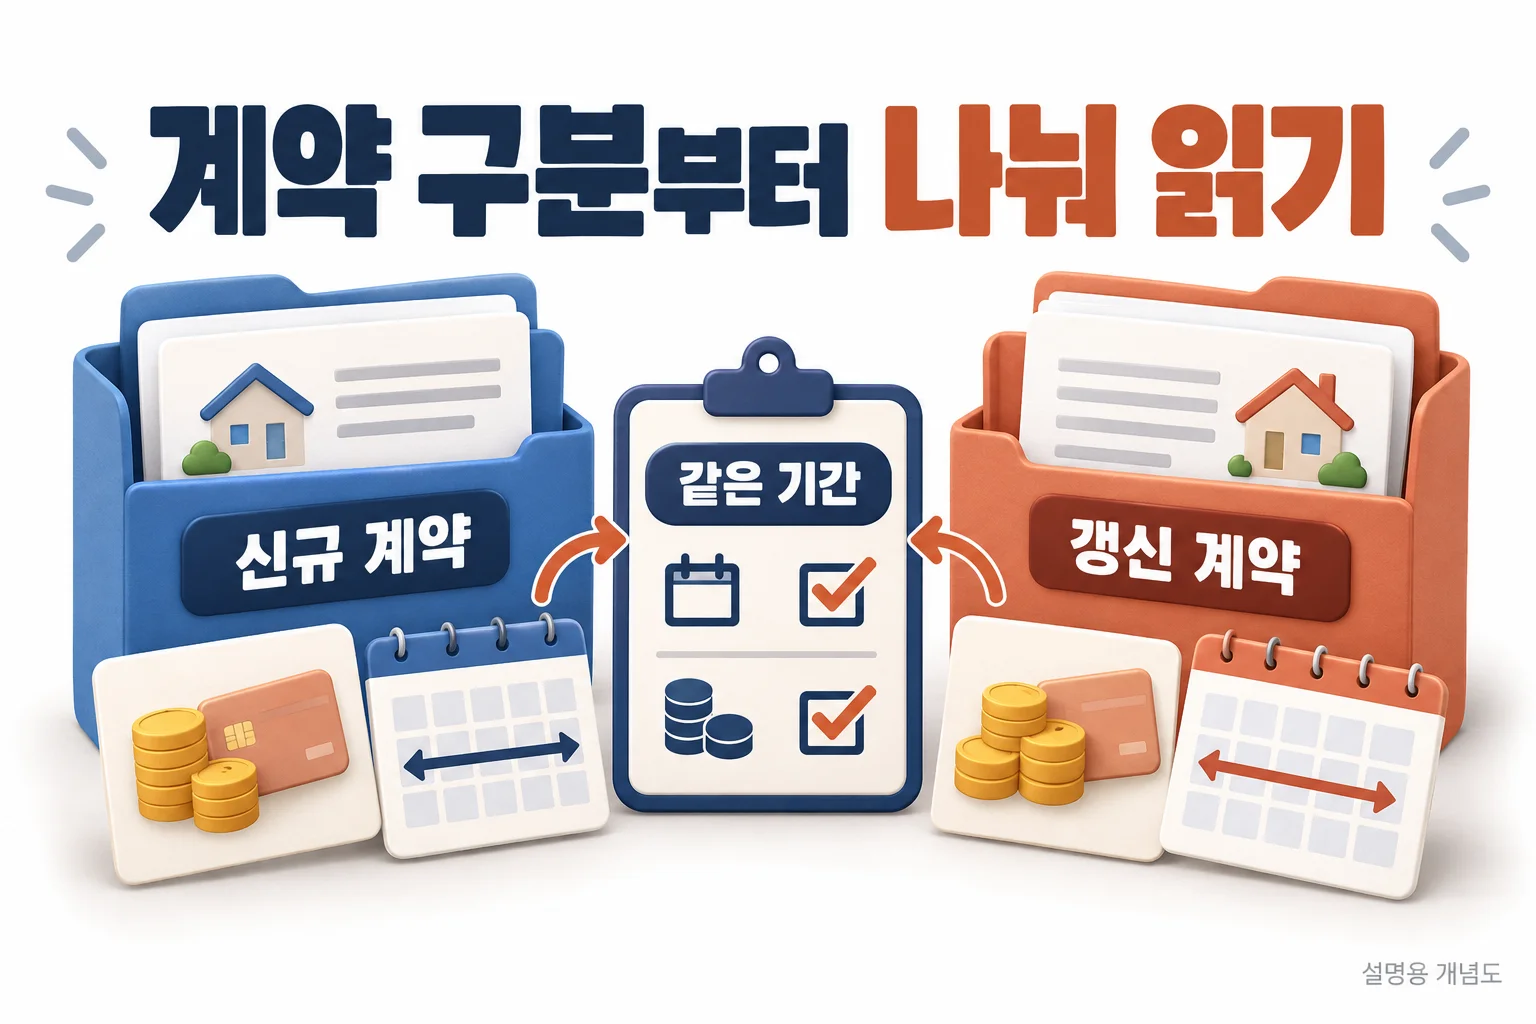
계약 구분이라는 추가 정보
국토교통부 전월세 공개 안내에는 신고 자료의 계약 기간과 신규·갱신 여부 등 추가 정보가 설명되어 있습니다. 실제 조회 화면에서 제공되는 항목을 확인하고, 구분 값이 있는 거래와 없는 거래를 나누어 기록하세요.
구분이 없다는 이유로 임의로 신규나 갱신이라고 채우면 원본에 없는 정보가 들어갑니다. 미표시라는 별도의 범주를 두면 자료가 설명하는 범위를 지킬 수 있습니다.
평균을 나누어 보는 예제
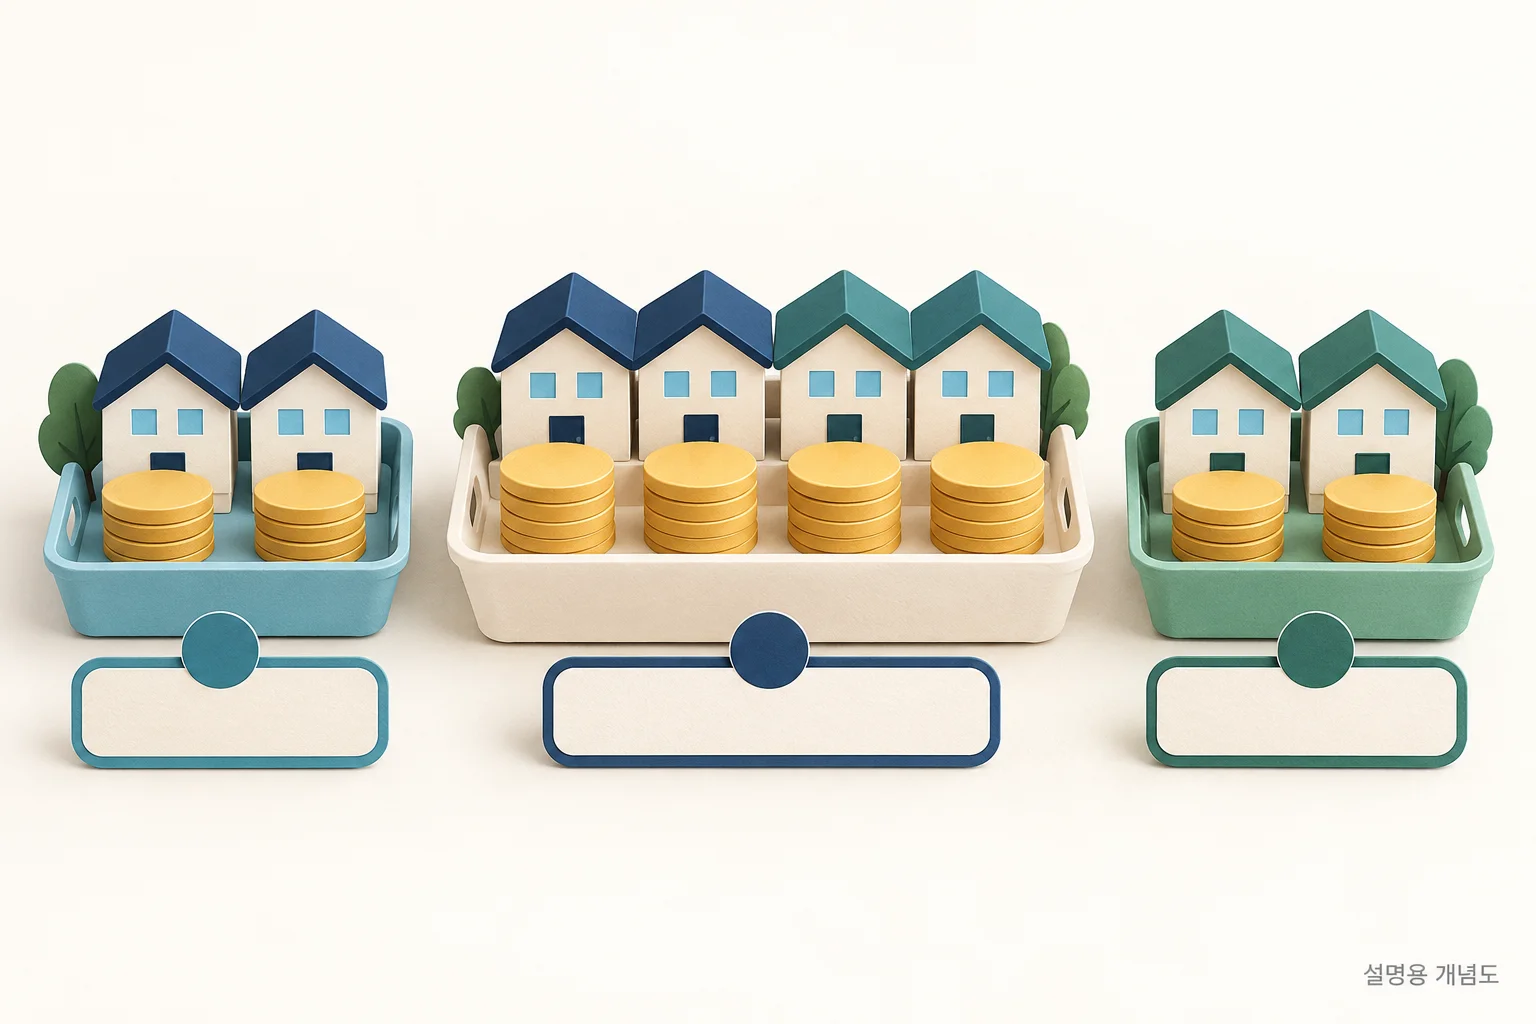
가상의 같은 면적 월세 거래가 신규 두 건은 각각 80만 원, 갱신 두 건은 각각 60만 원이라고 가정합니다. 전체 평균은 70만 원입니다. 하지만 신규 계약의 예시 조건을 알고 싶다면 신규 두 건의 80만 원이 더 직접적인 비교 자료입니다.
전체 평균이 잘못된 계산인 것은 아닙니다. 다만 다른 질문에 답하고 있습니다. “이 표에 들어온 계약의 평균”과 “신규 계약 표본의 평균”을 구분해 제목을 붙이면 결과의 용도를 명확히 할 수 있습니다.
계약 기간과 금액의 짝 맞추기
구분이 같더라도 계약 기간, 보증금, 월세, 면적이 다르면 조건이 완전히 같은 것은 아닙니다. 월세만 정렬하기 전에 보증금이 비슷한 거래끼리 묶고, 금액이 어떤 계약의 어느 시점 조건인지 확인합니다.
갱신 여부 하나로 금액 차이의 이유를 모두 설명하려고 하지 마세요. 이 글은 통계 표본의 구분을 다루며, 갱신권 행사 여부나 개별 계약의 법률상 효력을 판단하지 않습니다.
미표시 자료를 투명하게 정리하기
이 가상 다섯 행의 분류 건수는 신규 2건·갱신 2건·미표시 1건으로 합계 5건입니다. 분류별 평균을 만들 때도 각 분모를 같이 적습니다. 미표시 행을 제외한 네 건의 평균과 전체 다섯 건의 평균을 모두 ‘전체 평균’이라고 부르면 분류 작업이 만든 차이를 숨기게 됩니다.
미표시 비중이 큰데 이를 모두 제외하면 결과가 전체 계약의 특징과 다를 수 있습니다. 배제 자체보다 중요한 것은 무엇을 제외했는지 밝히는 일입니다. 다음 조회에서 구분 정보가 보완되면 같은 기준으로 다시 계산할 수 있습니다.
미표시 한 건을 다르게 분류하면 평균이 얼마나 바뀔까
위 가상 5행에서 미표시 100만 원 한 건의 분류를 바꾸면 결론이 얼마나 움직이는지 계산했습니다. 신규 80·80, 갱신 60·60이라는 입력은 유지합니다. 아래 두 대입은 가능한 조건을 비교하는 계산이며 실제 분류를 알아낸 결과가 아닙니다. 다른 보증금·면적·기간 차이는 없는 설명용 조건입니다.
| 분류 조건 | 신규 건수 | 신규 평균 | 갱신 건수 | 갱신 평균 | 미표시 건수 |
|---|---|---|---|---|---|
| 미표시 그대로 보존 | 2 | 80.00 | 2 | 60.00 | 1 |
| 미표시를 신규로 가정 | 3 | 86.67 | 2 | 60.00 | 0 |
| 미표시를 갱신으로 가정 | 2 | 80.00 | 3 | 73.33 | 0 |
미표시를 어느 쪽으로 넣어도 전체 다섯 건의 평균 76만 원은 같습니다. 그런데 신규 평균은 80에서 86.67로, 갱신 평균은 60에서 73.33으로 바뀔 수 있습니다. 전체 평균만 확인하면 분류에 따른 이 차이를 놓칩니다. 86.67과 73.33은 각각 260/3과 220/3을 소수 둘째 자리로 표시한 값입니다.
실제 비교표에는 미표시 건수와 비중(이 예제는 1/5)을 남기고 확인된 신규·갱신 평균을 따로 적습니다. 임의로 한쪽에 배정한 평균을 관측값으로 쓰지 않습니다. 추가 두 행은 민감도를 설명할 뿐 누락 자료의 실제 분류나 시장 전체의 범위를 추정하지 않습니다. 가상 5행 CSV를 내려받아 조건을 확인할 수 있습니다.
이 글의 CSV 다섯 행만으로 다시 계산하기
2026.10.29 재현 경로를 분리했습니다. 앞서 연결한 통합 코드는 종로구 저장자료 JSON을 입력받고 임대 분류 예제는 코드 안의 고정 목록으로 계산했습니다. 이제 아래 전용 코드는 내려받은 CSV의 각 행을 실제로 읽습니다. 이 예제에 무관한 실거래 36행 파일은 필요하지 않습니다. 원래 가상 CSV의 값과 작성일은 그대로입니다.
- 입력 CSV와 전용 Python 코드를 같은 폴더에 저장합니다.
- Python 3 표준 라이브러리만 사용합니다. 별도 패키지 설치·네트워크·API 키가 필요하지 않습니다.
- 다음 명령으로 새 결과 파일을 만들고 공개한 입력·정확한 분수·표시값 결과와 대조합니다. 기존 파일명은 덮어쓰지 않습니다.
python3 reproduce-lease-classification.py --input lease-classification-synthetic-20261023.csv --output lease-result.json원본 CSV는 전체 count=5, sum_exact=380, mean_exact=76입니다. 미표시를 신규로 가정한 평균은 260/3, 갱신으로 가정한 평균은 220/3입니다. 별도 복사본에서 L5의 monthly만 100에서 0으로 바꾸면 전체 평균은 56, 두 가정의 평균은 각각 160/3·40으로 바뀌어야 합니다. 이는 코드가 입력을 읽는지 확인하는 대조이며 공란 kind를 신규·갱신으로 알아냈다는 뜻이 아닙니다. 금액 0과 분류 공란은 별도로 처리합니다.
미표시 한 건이 포함된 5행을 분류해 보기
| 계약 구분 | 가상 월세 입력(만원) | 건수 | 평균 월세(만원) |
|---|---|---|---|
| 신규 | 80, 80 | 2 | 80 |
| 갱신 | 60, 60 | 2 | 60 |
| 미표시 | 100 | 1 | 100 |
| 전체 | 위 5행 | 5 | 76 |
| 구분 확인 행만 | 신규·갱신 4행 | 4 | 70 |
신규 80·80, 갱신 60·60의 합계는 280만원이므로 확인된 네 행의 평균은 70만원입니다. 여기에 미표시 100만원을 포함하면 380÷5=76만원입니다. 70과 76의 차이는 같은 다섯 행의 금액이 변해서가 아니라 계산에 넣은 행이 달라서 생깁니다. 미표시를 어느 계약 종류로 넣을지는 이 산술로 알아낼 수 없습니다.
미표시를 별도 범주로 남겨 검산하기
- 가상 5행 CSV를 열고 계약구분 공란 한 행을 찾습니다.
- 신규·갱신·미표시 건수의 합이 전체 5건인지 확인합니다. 빈칸을 0원 월세로 바꾸지 않습니다.
- 구분별 합계와 건수를 따로 계산한 다음 나눕니다. 실제 자료에서는 면적·보증금·기간도 맞춰야 합니다.
이 비교는 갱신권 행사 여부나 개별 계약의 효력을 판단하지 않습니다. 분류별 계산 결과에서 공란을 유지한 결과를 확인할 수 있습니다.
읽고 나서 확인할 것
- 미표시 거래를 임의로 분류하지 않았는가?
- 신규·갱신 각각의 표본 수를 남겼는가?
- 보증금과 면적 조건도 확인했는가?
편집자 의견
계약 종류별 평균을 발표할 때는 미표시 건수와 비중도 같은 표에 남기겠습니다. 가상 다섯 행은 전체 평균이 같아도 미표시 한 건의 분류에 따라 신규·갱신 평균이 바뀌어, 전체 합계만으로 분류 결과를 검증할 수 없었습니다.
분류를 확인하지 못한 행은 원래 미표시 상태로 보존하겠습니다. 어느 쪽에 넣었을 때의 계산은 민감도 비교로만 보여 주고 그 대입을 실제 계약 종류를 알아낸 결과로 쓰지는 않겠습니다.